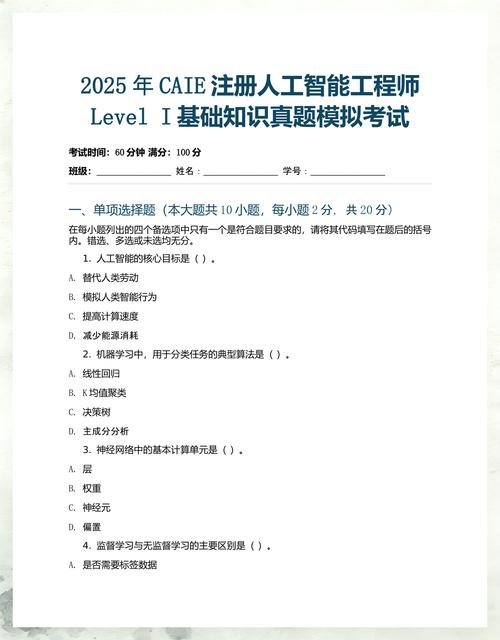
一、考试概览
CAIE(Certified Artificial Intelligence Engineer)注册人工智能工程师Level I认证旨在评估考生在人工智能基础软件开发领域的核心知识与实践能力。2025年考试大纲强调对基础理论、常用算法、软件开发流程及伦理规范的综合掌握。以下为模拟试题,涵盖选择题、简答题与编程题,供考生自测。
二、模拟试题
(一)单项选择题(每题2分,共20分)
1. 在人工智能基础软件开发中,以下哪项不是Python作为首选语言的主要原因?
A. 丰富的机器学习库(如scikit-learn、TensorFlow)
B. 动态类型与解释执行特性
C. 强制静态类型检查
D. 庞大的社区支持
2. 关于监督学习与无监督学习,说法正确的是:
A. 监督学习需要标注数据,无监督学习不需要
B. 监督学习不需要标注数据,无监督学习需要
C. 两者均需要标注数据
D. 两者均不需要标注数据
3. 在神经网络中,激活函数的主要作用是:
A. 增加计算复杂度
B. 引入非线性,使网络能拟合复杂函数
C. 减少参数数量
D. 替代损失函数
4. 以下哪个不是模型评估的常用指标?
A. 准确率(Accuracy)
B. 召回率(Recall)
C. 代码覆盖率(Code Coverage)
D. F1分数(F1-score)
5. 在软件开发中,版本控制工具Git的核心功能是:
A. 自动化测试
B. 代码托管与版本管理
C. 性能分析
D. 依赖管理
6. 关于过拟合(Overfitting),以下描述正确的是:
A. 模型在训练集上表现差,在测试集上表现好
B. 模型在训练集和测试集上均表现差
C. 模型在训练集上表现好,在测试集上表现差
D. 模型参数过少导致
7. 下列哪种方法常用于防止过拟合?
A. 增加模型复杂度
B. 使用正则化(L1/L2)
C. 减少训练数据
D. 增加特征数量
8. 在Flask Web框架中,用于定义路由的装饰器是:
A. @app.route
B. @app.get
C. @app.post
D. @app.path
9. 关于数据预处理中的标准化(Standardization),以下说法正确的是:
A. 将数据缩放到[0,1]区间
B. 将数据变换为均值为0、方差为1的分布
C. 删除缺失值
D. 对类别特征进行独热编码
10. 在人工智能应用中,伦理考量不包括以下哪项?
A. 数据隐私保护
B. 算法公平性
C. 系统性能优化
D. 透明性与可解释性
(二)简答题(每题10分,共30分)
- 简述人工智能基础软件开发的一般流程,并说明每个阶段的主要任务。
- 解释梯度下降(Gradient Descent)的基本原理,并说明学习率对训练过程的影响。
- 在开发一个机器学习分类模型时,如何划分训练集、验证集和测试集?各数据集的作用是什么?
(三)编程题(共50分)
- (20分)使用Python和scikit-learn库,编写代码实现以下功能:
- 加载鸢尾花(Iris)数据集;
- 将数据集划分为训练集和测试集(测试集比例0.2,随机种子42);
- 使用逻辑回归(Logistic Regression)进行训练;
- 输出模型在测试集上的准确率。
- (30分)使用Python和Flask框架,创建一个简单的Web API,接收JSON格式的输入(包含特征数组),调用已训练好的模型(假设模型已保存为model.pkl)进行预测,返回JSON格式的预测结果。要求包含错误处理(如输入格式错误返回400状态码)和必要的依赖导入。
三、参考答案与解析
(一)单项选择题
- C(Python非强制静态类型检查)
- A
- B
- C(代码覆盖率是软件测试指标,非模型评估指标)
- B
- C
- B
- A
- B
- C(性能优化属于技术考量,不是伦理范畴)
(二)简答题要点
- 流程包括:需求分析、数据收集与预处理、模型选择与训练、模型评估与调优、部署与监控。需求分析明确目标;数据预处理清洗和转换数据;模型训练选择合适的算法;评估使用交叉验证和指标;部署将模型集成到应用并持续监控性能。
- 梯度下降通过迭代沿损失函数梯度的反方向更新参数,以最小化损失。学习率决定步长:过大导致震荡不收敛,过小导致收敛缓慢。
- 通常按比例(如60%/20%/20%)随机划分。训练集用于模型训练;验证集用于超参数调优和模型选择;测试集用于最终评估泛化能力,不参与训练和调优。
(三)编程题参考
1. `python
from sklearn.datasets import loadiris
from sklearn.modelselection import traintestsplit
from sklearn.linearmodel import LogisticRegression
from sklearn.metrics import accuracyscore
iris = loadiris()
X, y = iris.data, iris.target
Xtrain, Xtest, ytrain, ytest = traintestsplit(X, y, testsize=0.2, randomstate=42)
model = LogisticRegression(maxiter=200)
model.fit(Xtrain, ytrain)
ypred = model.predict(Xtest)
print("Accuracy:", accuracyscore(ytest, y_pred))`
2. `python
import pickle
import numpy as np
from flask import Flask, request, jsonify
app = Flask(name)
model = pickle.load(open('model.pkl', 'rb'))
@app.route('/predict', methods=['POST'])
def predict():
try:
data = request.get_json()
features = np.array(data['features']).reshape(1, -1)
prediction = model.predict(features).tolist()
return jsonify({'prediction': prediction})
except Exception as e:
return jsonify({'error': str(e)}), 400
if name == 'main':
app.run(debug=True)`
四、备考建议
- 夯实基础:掌握Python编程、数据结构、常用机器学习算法(线性回归、逻辑回归、决策树、神经网络基础)。
- 熟悉工具链:熟练使用NumPy、Pandas、scikit-learn、Matplotlib,了解Flask/Django用于模型部署。
- 理解流程:将软件工程思想(版本控制、测试、文档)融入AI开发。
- 关注伦理:了解数据隐私、公平性等规范,可能会在考试中以案例分析形式出现。
通过以上模拟练习,考生可检验知识掌握程度,查漏补缺,从而在CAIE Level I考试中取得优异成绩。